
强化学习
强化学习
从样本平均法开始
行动-价值更新函数如下:
$$
Q_{n+1} = \frac{1}{n} \sum_{i=1}^{n} R_i
$$
通过以下推导:
$$
\begin{eqnarray}
Q_{n+1} &=& \frac{1}{n} \sum_{i=1}^{n} R_i\
&=& \frac{1}{n} (R_n + \sum_{i=1}^{n-1} R_i)\
&=& \frac{1}{n} (R_n + (n-1)Q_n)\
&=& Q_n + \frac{1}{n} (R_n - Q_n)\
\end{eqnarray}
$$
我们可以把样本平均法的行动-价值更新公式转换为如下:
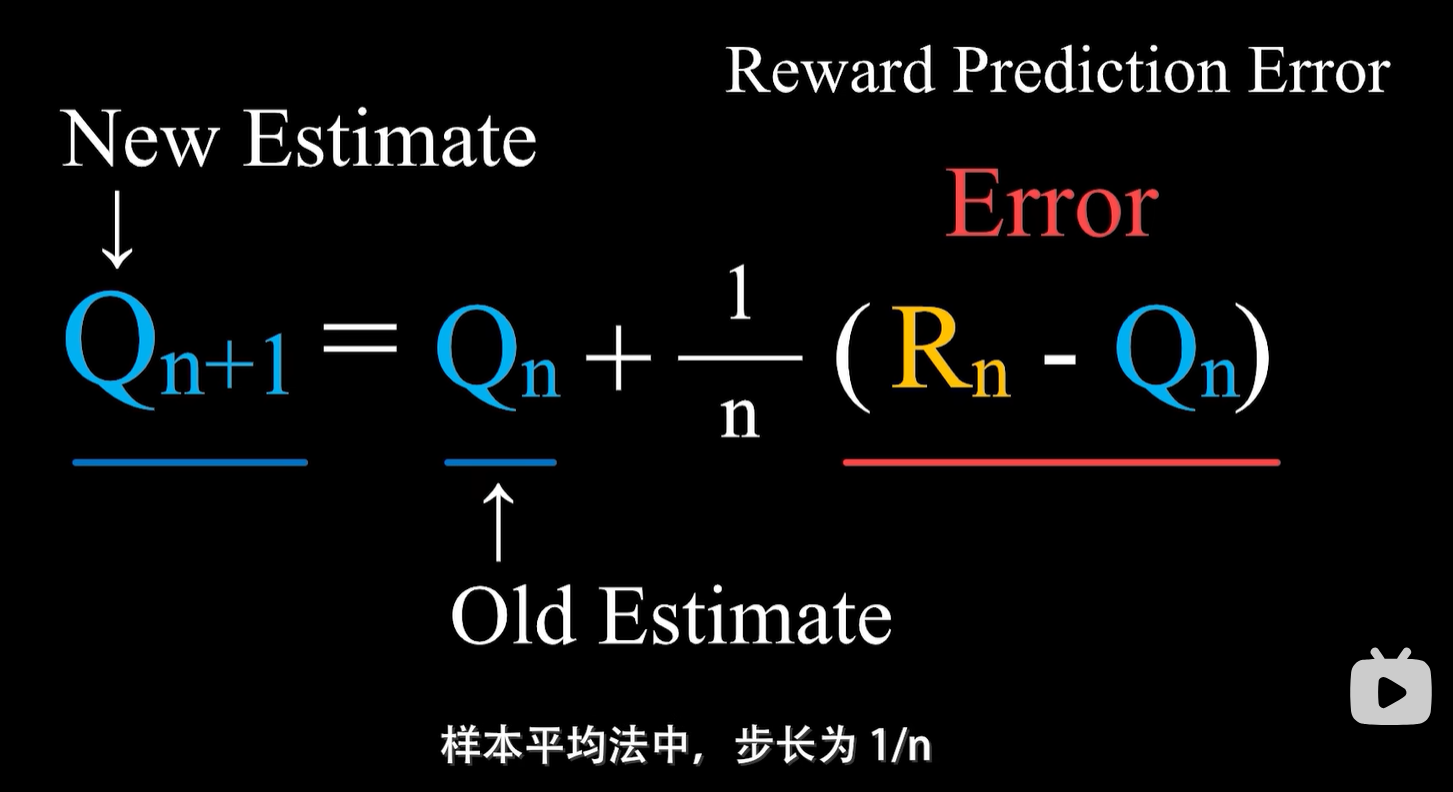
上述式子当中,说明$1/n$是步长,随着我们尝试的次数$n$不断增加,最近得到的误差的权重占比也会越来越低。为了解决这个问题,那么也可以把步长设置为一个常数$\alpha$(这就是加权平均):
$$
\begin{eqnarray}
Q_{n+1} &=& Q_n + \alpha (R_n - Q_n)\
&=&…\
&=& (1-\alpha)^{n}Q_{1}+\sum_{i=1}^{n} \alpha(1-\alpha)^{n-i}R_i\
\end{eqnarray}
$$
显然,这样的算法更加适用于奖励分布可能会随时间发生改变的情况。
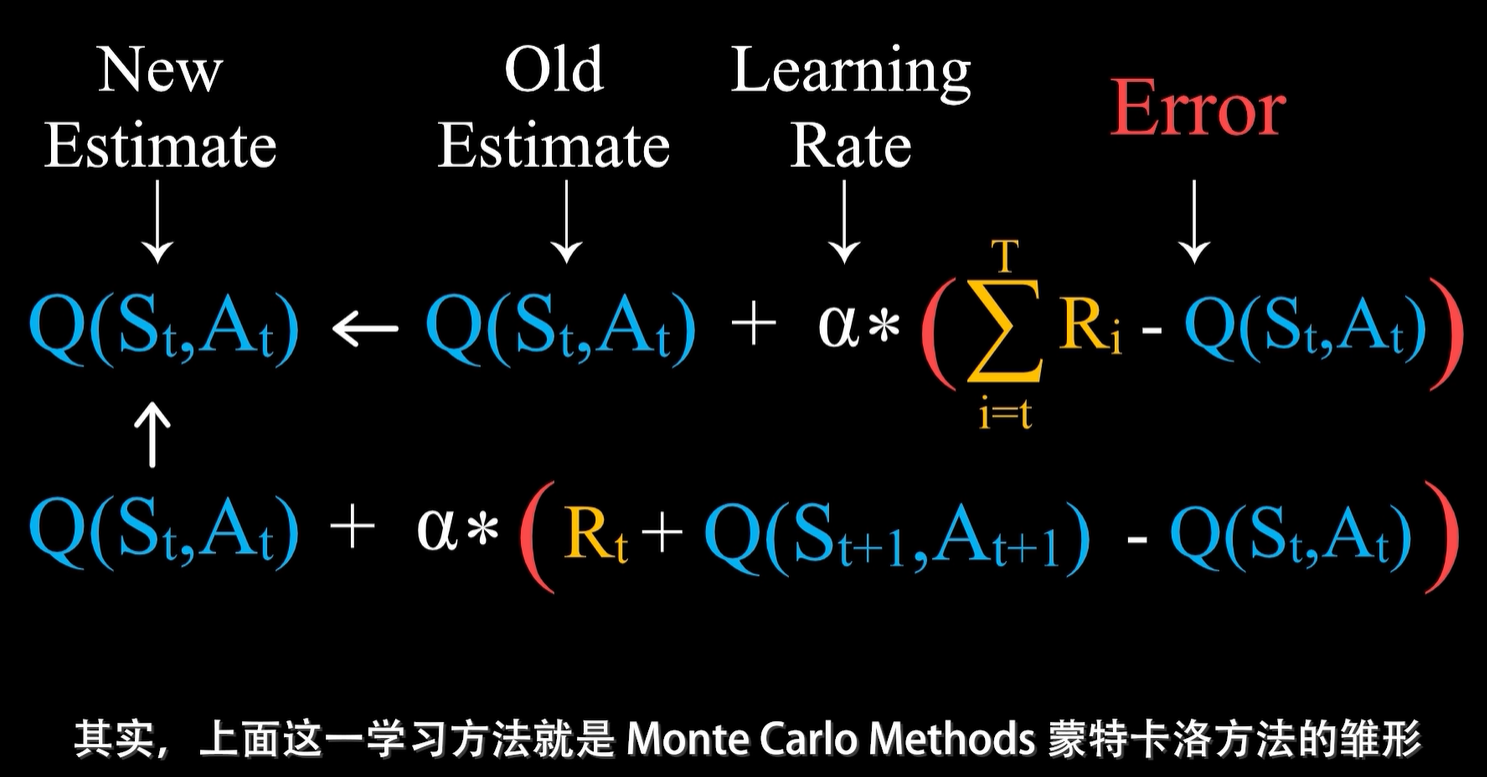
一些其他的方法:

本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来自 ChengHuiWan-cy的博客!
